稀疏注意力 / DSA:用白话讲清在优化什么
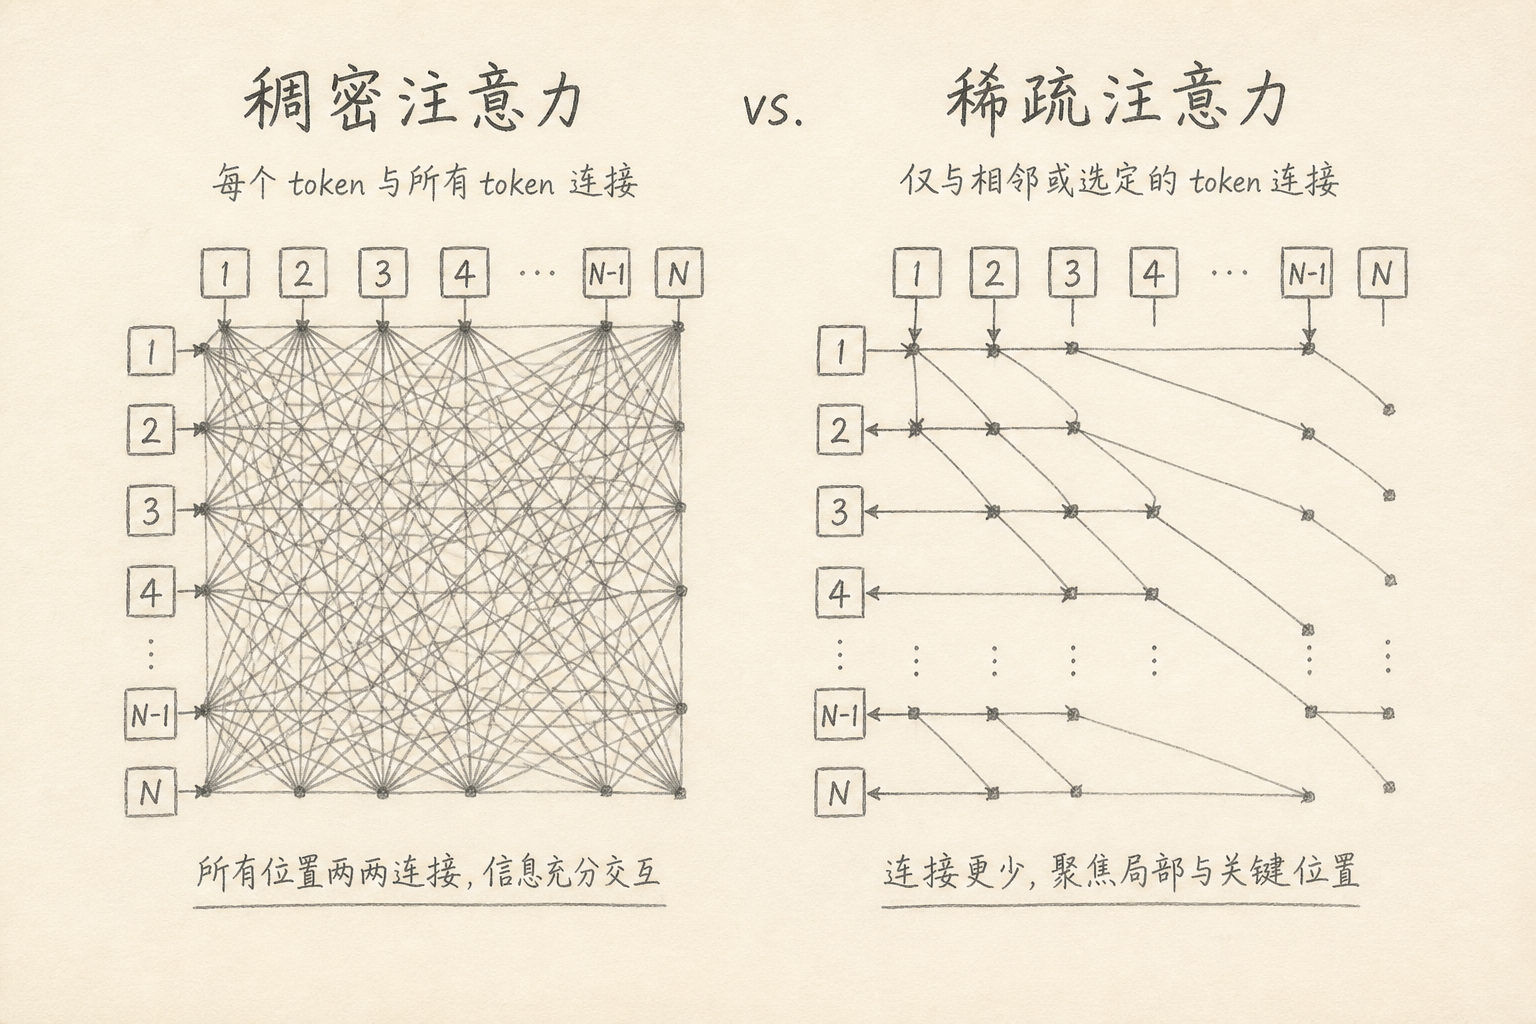
稀疏注意力(sparse attention)指:计算注意力时,不让每个位置都与序列里所有位置两两交互,只连接一部分位置。
长上下文越来越常见,全量注意力的代价也越来越显眼。资料里又出现 DSA、各种稀疏模式缩写。先抓住它在优化什么,再记名字。
一、先说一个具体麻烦
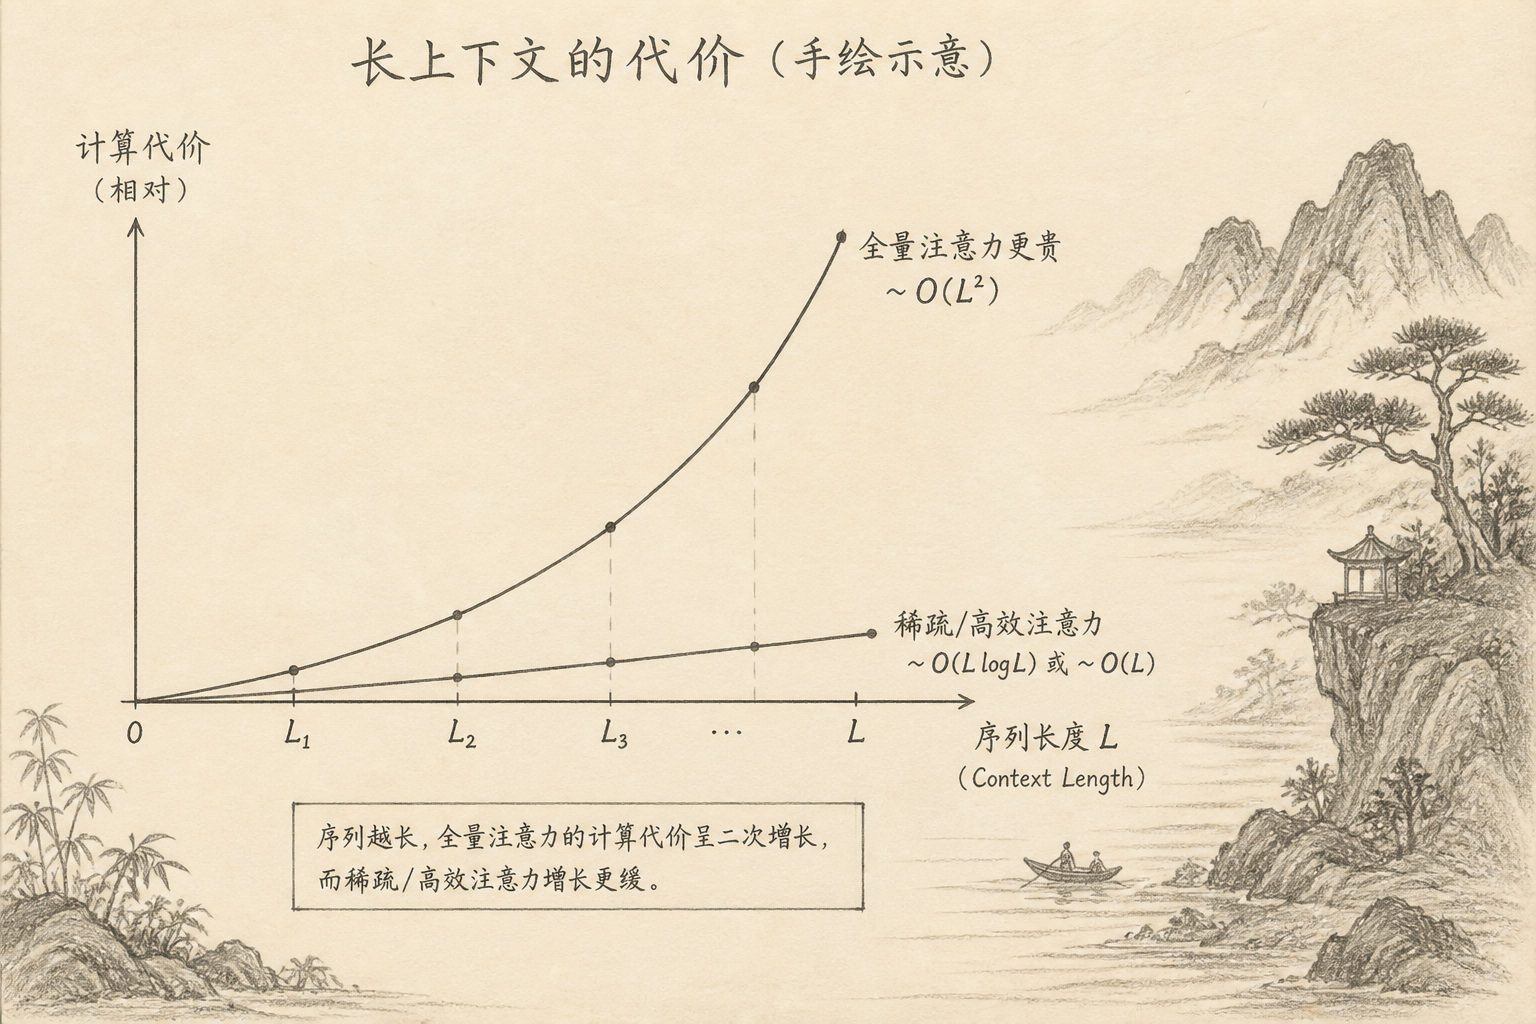
序列长度变长时,经典注意力大致要让每个 token「看」所有 token。长度翻倍,计算与某些内存项往往差很多,不只线性涨一点。
于是出现矛盾:既想窗口大,又想跑得动、用得起。稀疏注意力是应对思路之一:减少必须计算的关系对。
二、核心思路:不必每次全员开会
把每个 token 当成会议室里的人。稠密注意力:每人发言都要听所有人。人一多,会开不完。
稀疏注意力:每人只听邻居、只听被点名的关键人物、或按规则抽样听一部分。信息可能略损,但会议成本下降。
所谓优化,主要针对:
(1)计算量(FLOPs)
(2)内存(尤其随长度变差的部分)
(3)从而支撑更长上下文或更低延迟/成本
三、DSA 等名字怎么放进脑子里
具体算法名(如各类 Sparse / DSA 实现)是「按什么规则选要听的人」。不同论文与产品路线不同。
对使用者:
(1)不必先背全称
(2)先问:相对稠密,它稀疏了哪类连接?质量声明如何?
(3)再问:你的任务是否长依赖很强(可能对稀疏更敏感)
把 DSA 当成「稀疏注意力家族里的一种实现称呼」即可;以你跟进的模型卡与论文为准,名称会迭代。
四、它不保证什么
(1)不自动提高智力
(2)不消除所有长程依赖需求
(3)不等于可以无限上下文零代价
(4)与 MoE、量化等正交:可以组合,但别混成一个词
五、什么时候需要关心
值得关心:你在选长上下文模型、看延迟/费用、或读模型技术报告。
可以后补:只做短提示日常聊天,先把产品和评测做好。
六、常见误区
(1)稀疏 = 一定更快更好
看实现与硬件。
(2)窗口数字单独决定体验
还有检索、摘要、产品策略。
(3)把所有长上下文技术都叫稀疏注意力
还有分块、状态压缩、检索增强等。
七、小结
稀疏注意力优化的是「每个位置是否必须关注所有位置」带来的算力与内存压力。名字可以后记;先记住:用更少的连接,换更可承受的长序列成本,并接受潜在的信息取舍。
(完)