上下文工程加强版详解:窗口、裁剪、工具结果与评测
前两月写得最多、也最适合加码的题型,是「理解 X」与 Agent 基础:窗口、token、工具、裁剪、评测。各篇分开读够用;工程上它们是同一条链。
本文当加强版详解:把分散概念收成上下文工程最小闭环。无真实后台数据时,选题依据是计划内高频主线,而非伪造点击率。
一、一句话定义
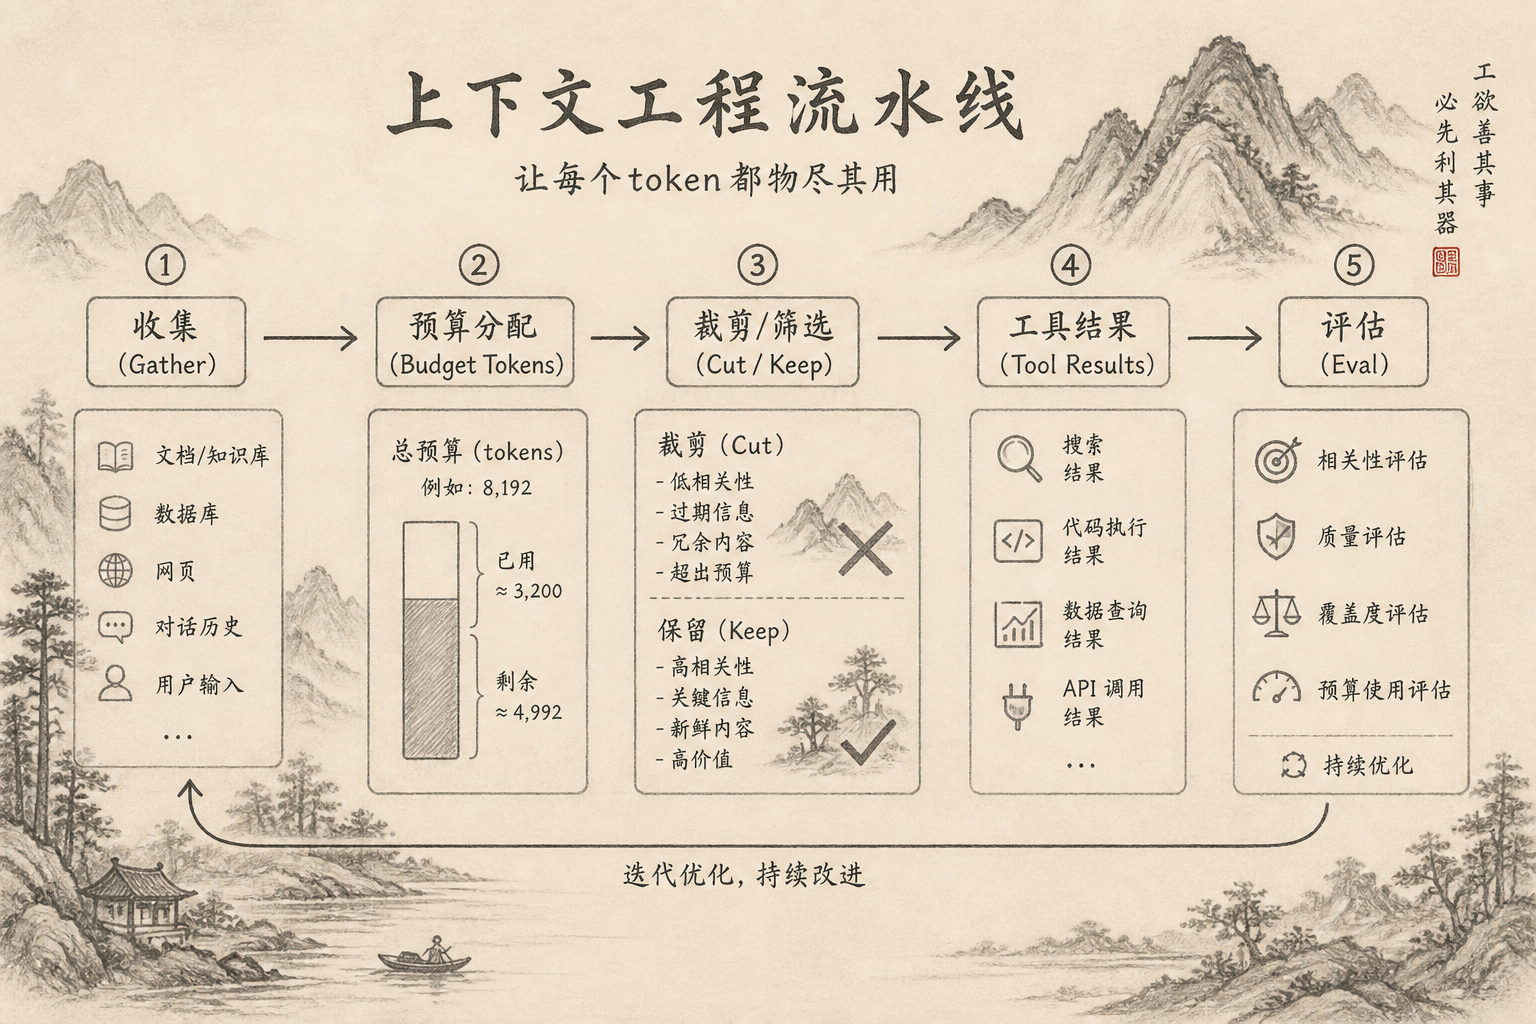
上下文工程:在有限窗口里,为模型选对、放对、管好材料,并用评测证明这样做是否真的更好。
它不只是「把提示写长」。
二、窗口与 token:容量合同
上下文窗口是一次请求可见材料的上限;token 是尺子。
工程含义:
(1)系统提示、工具说明、历史、检索、工具结果、输出预算抢同一块容量
(2)标称 128K ≠ 你有 128K 业务正文
(3)先看 usage,再凭感觉
(细节见早期「理解上下文窗口」;此处只取合同视角。)
三、材料分层:什么配长期驻留
建议四层:
(1)宪法层:安全与硬约束,短而稳
(2)任务层:目标、范围、验收,每任务更新
(3)事实层:已确认摘要,可替换流水历史
(4)证据层:当前相关代码/日志切片,用完可丢
错位的典型:把证据层全历史永久塞进宪法层。
四、裁剪算法(可执行)
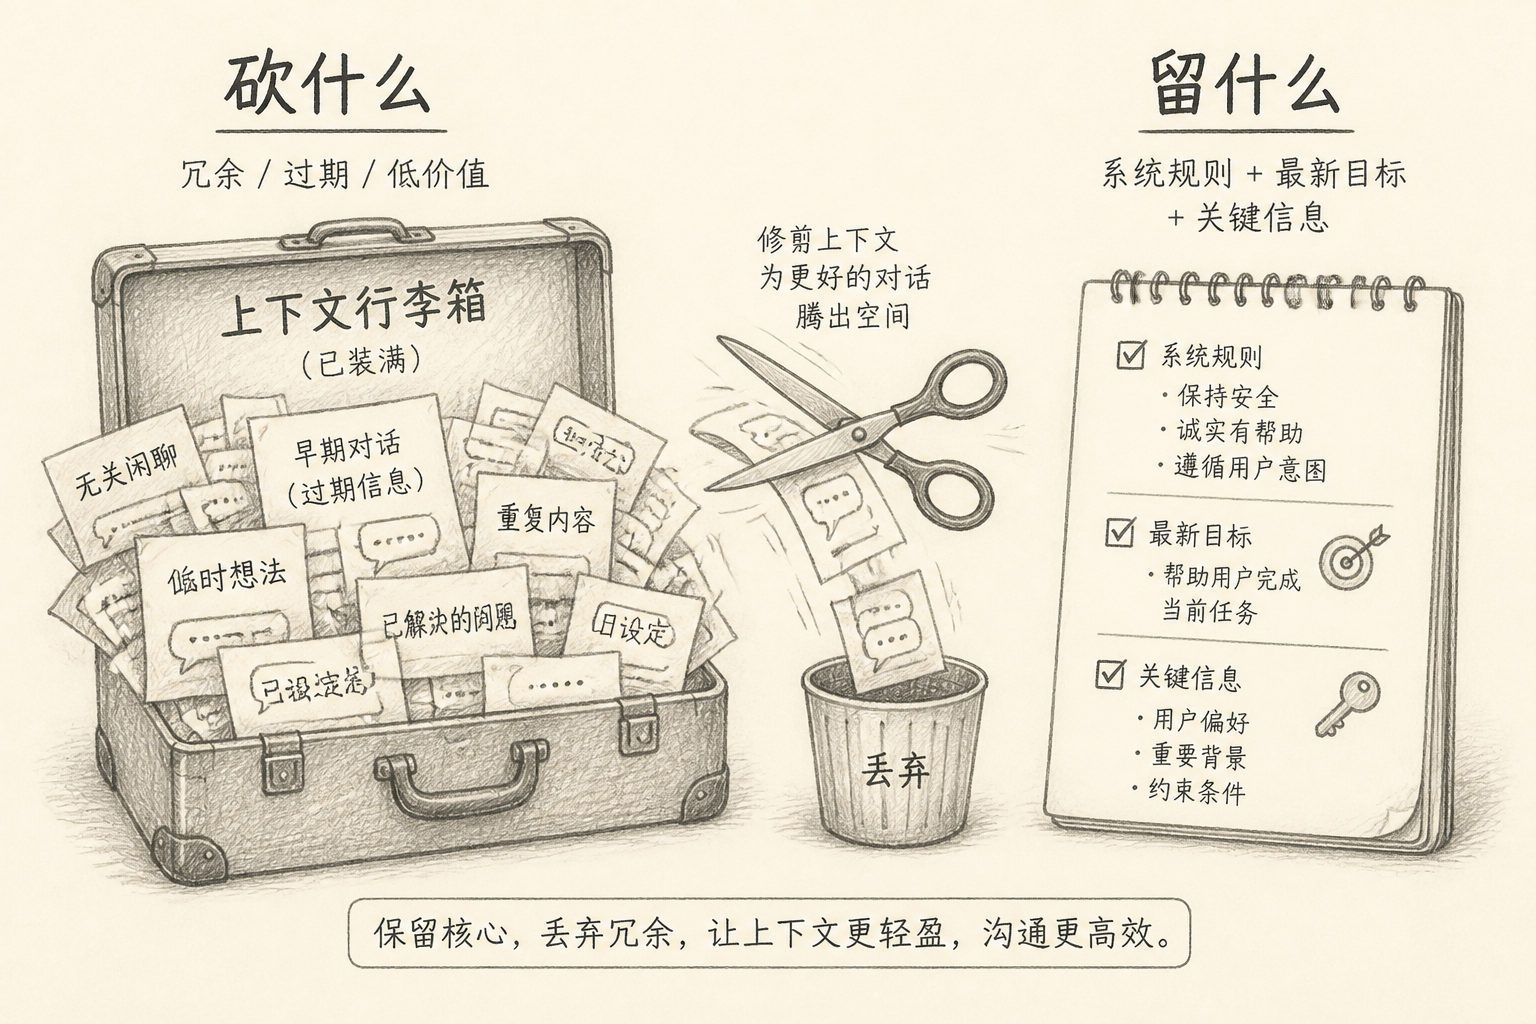
当接近预算或信噪比变差:
(A)删重复日志,留末次 + 结论
(B)将旧轮次折叠进「已确认」摘要
(C)大文件改为检索命中片段
(D)保证验收条件永不被裁掉
(E)新子任务可新开线程,携带摘要
砍的是轨迹,不是目标。
五、工具结果:第三种上下文污染源
工具一多,失败栈与巨型 stdout 会占满窗。
治理:
(1)返回结构化错误码(见工具失败三层)
(2)截断 stdout,保留尾部 N 行
(3)禁止把整库 dump 进对话
(4)写操作结果用「变更摘要」代替全 diff 常驻
六、与结构化输出、MCP 的接口
(1)要程序接龙,用 schema,不要散文假装 JSON
(2)MCP / 插件扩权后,工具说明本身也占窗——控制工具数量
(3)约束 + 验收写进任务层,减少乱调用
七、用评测集关闭虚荣指标
没有评测,裁剪策略只是审美。
最小闭环:
(1)固定 20 道丑题(含长上下文与工具失败)
(2)改裁剪策略后重跑
(3)看通过率、费用、越权率
(4)演示成功的题收进集合
上下文工程的 KPI 是评测,不是「窗开到最大」。
八、一张实践检查单
[ ] 宪法层 < N token,且本周无脏内容混入
[ ] 每任务有范围与验收
[ ] 有摘要槽,旧历史可折叠
[ ] 工具输出有截断与错误码
[ ] 接近预算有自动/半自动裁剪
[ ] 裁剪策略变更必跑评测子集
九、常见误区
(1)只扩窗
(2)摘要空洞
(3)工具全开
(4)无评测凭感觉
(5)把检索当装饰,仍全量粘贴
十、小结
加强版不讲新神话,只把窗口、裁剪、工具结果与评测接成闭环。上下文工程做得好,模型像更聪明;其实是材料终于配得上那个模型。
(完)